Messbare Projektion-Frische: Echtzeit-Snapshot-Alter im Reed Producer Pipeline
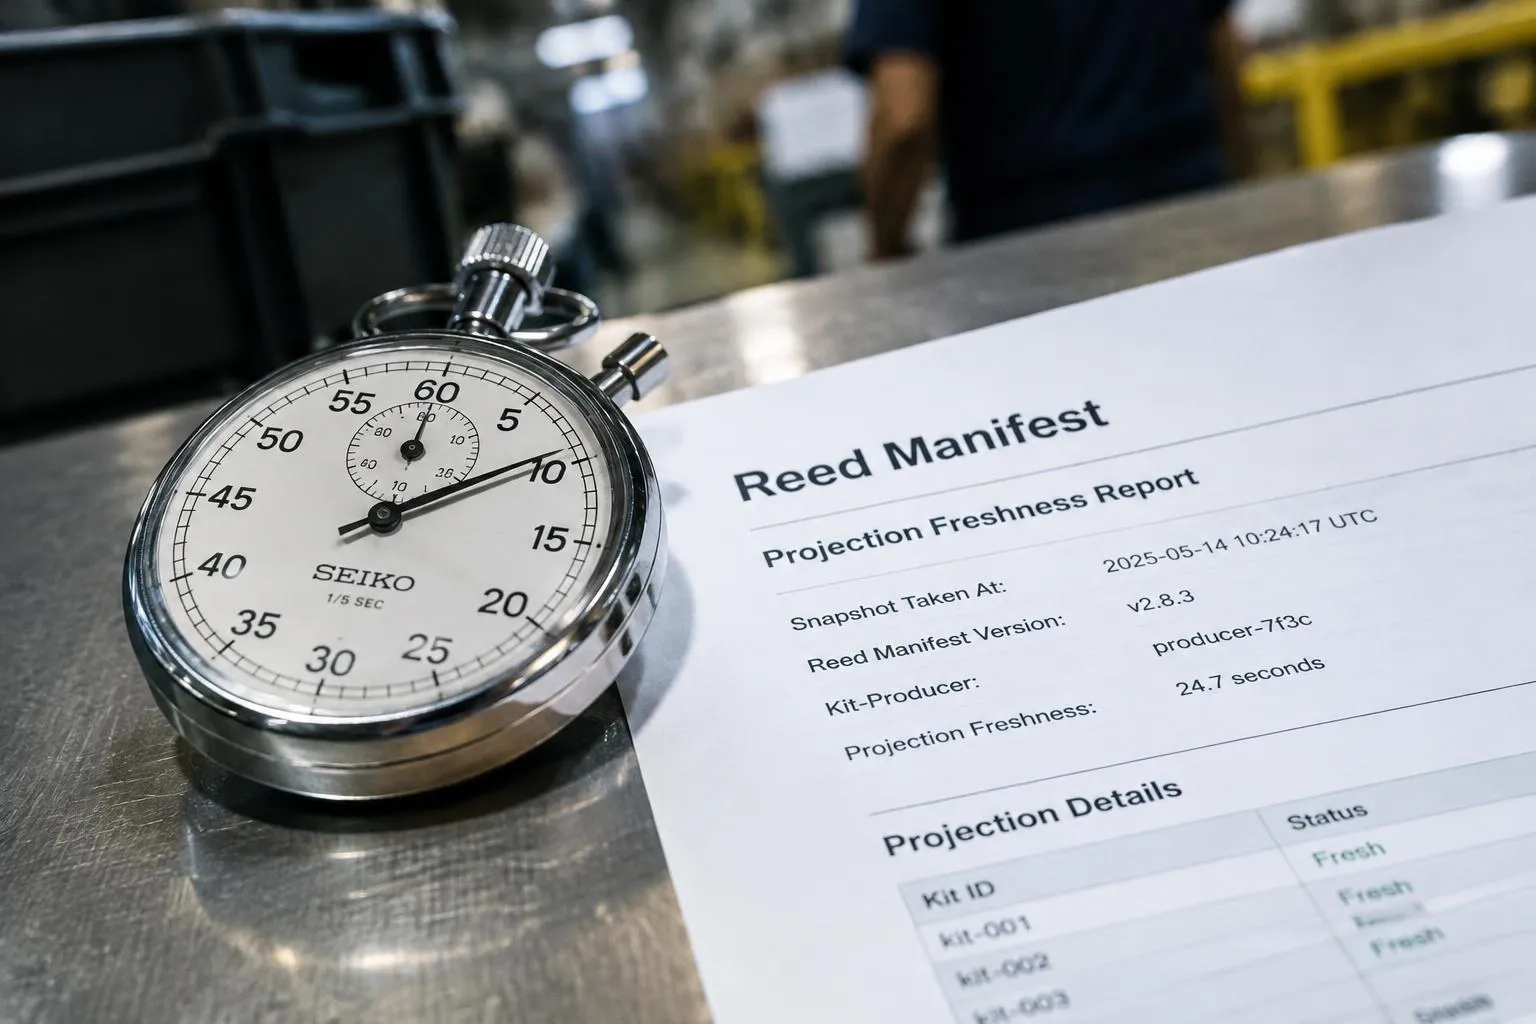
Ab sofort bietet der Helpifyr / JaddaHelpifyr Stack eine neue Laufzeitgarantie: Jeder Kit-Producer schreibt nun die exakte Frische seines Readiness-Snapshots, gemessen in Echtzeit und verankert durch das aktuelle Reed Manifest. Diese Neuerung ermöglicht es Operatoren und Integratoren, auf belastbare Live-Daten zur Projektion-Aktualität zu reagieren, wodurch eine bisherige Blindstelle geschlossen wird, die veraltete Daten als bereit erscheinen ließ. Für Entwickler wird projection_fresh so zu einem quantifizierten, verlässlichen Signal und nicht mehr nur zu einem booleschen Wert.
 Jadda Helpifyr3 Min. Lesezeit
Unterstrichene Begriffe sind erklärt: einfach darauf zeigen oder tippen.
Stellen Sie sich vor, Sie rollen um 16 Uhr eine neue Kundenintegration aus und stellen um 19 Uhr fest, dass das System immer noch Daten aus einem Snapshot von der Mittagszeit ausliefert. Bis heute konnte die Helpifyr Kit-Pipeline lediglich anzeigen, ob ein Readiness-Snapshot existierte - nicht jedoch, wie alt dieser ist oder ob er den aktuellen Upstream-Zustand widerspiegelt. Diese Lücke zwang Operatoren dazu, über die tatsächliche Aktualität ihrer Projektionen zu spekulieren, während Entwickler sporadische Vorfälle untersuchen mussten, bei denen ‘bereit’ nicht gleichbedeutend mit ‘frisch’ war. Das führte zu Nutzerverwirrung, verzögerter Incident-Triage und fragilen Workarounds. Die zentrale Frage lautete: Wie machen wir nicht nur die Bereitschaft, sondern auch das tatsächliche Alter der zugrundeliegenden Daten sichtbar, damit alle Beteiligten fundierte Entscheidungen treffen können?
01
Warum dieser Tag wichtig war
Dieser Tag ist bedeutsam, weil er eine kritische Blindstelle durch messbare, handlungsrelevante Evidenz ersetzt. Für Operatoren offenbart die neue projection_fresh-Metrik das Live-Alter des Readiness-Snapshots und ermöglicht so das frühzeitige Erkennen von Veralterung, bevor sie für Nutzer zum Problem wird. Statt auf indirekte Signale zu vertrauen oder auf Symptome zu warten, können sowohl automatisierte Überwachung als auch menschliche Operatoren nun die tatsächliche Datenaktualität einsehen und darauf reagieren. Für Entwickler verändert sich der Vertrag: Integrationen und Health-Checks können programmatisch nicht nur ‘bereit’, sondern ‘frisch genug’ verlangen, was sicherere Rollouts, präzisere Canary-Deployments und schnellere Incident-Reaktionen ermöglicht. Nutzer profitieren von weniger Überraschungen, da Daten nun nachweislich aktuell sind und Veralterung frühzeitig erkannt wird. Zudem eröffnet das neue Signal Potenziale für selbstheilende Automatisierung: Systeme können gezielt Refreshes auslösen oder eskalieren, wenn das tatsächliche Datenalter es erfordert - anstatt blind auf die Qualität der Bereitschaft zu vertrauen.
Der abgeschlossene UTC-Tag 2026-10-25 umfasste 39 zusammengeführte PRs in 10 Repos.
02
Was sich tatsächlich geändert hat
Die grundlegende Änderung ist architektonischer Natur: Kit-Producers im Reed-Subsystem schreiben nun eine projection_fresh-Metrik zusammen mit ihrem Readiness-Snapshot. Diese Metrik ist kein einfacher Flag, sondern ein messbarer Wert, der das Alter des Snapshots zum Zeitpunkt des Schreibens quantifiziert und direkt mit dem Reed Manifest verknüpft, das Inhalt und Struktur der Projektion definiert. Die Pipeline gibt nun sowohl die Existenz eines Snapshots als auch dessen gemessene Frische aus und schließt damit die Lücke, in der ein ‘bereit’-Flag der Realität hinterherhinken konnte. Realisiert wird dies durch Instrumentierung des Snapshot-Write-Pfads, der den aktuellen Zeitstempel aufzeichnet und das Delta zum letzten Manifest-Update berechnet. Das Ergebnis ist ein verlässliches Artefakt, das von Downstream-Consumer, Health-Checks und Automatisierung ausgelesen, geprüft und durchgesetzt werden kann. Es handelt sich nicht nur um ein neues Feld in einer Datenbank, sondern um einen neuen Vertrag im Deployment- und Laufzeitmodell - mit Evidenz, die sowohl maschinen- als auch menschenlesbar ist.
03
Warum es jetzt besser hält
Das neue Modell überzeugt, weil es implizite, verlustbehaftete Signale durch explizite, messbare Evidenz ersetzt. Bisher konnten Readiness-Snapshots - insbesondere bei partiellen Ausfällen oder Verzögerungen im Upstream - veralten, ohne dass Consumer zwischen frischem und altem Zustand unterscheiden konnten. Jetzt macht die gemessene projection_fresh-Metrik Veralterung sichtbar und quantifizierbar, wodurch Ratespiele und das Risiko, auf veraltete Daten zu agieren, entfallen. Der Mechanismus ist robust gegenüber Edge-Cases: Da die Metrik sowohl an die Schreibzeit als auch an die Manifest-Version gebunden ist, kann sie nicht durch versehentliches Wiederverwenden von Snapshots oder verzögerte Writes verfälscht werden. Operatoren können feste Schwellenwerte für zulässiges Datenalter setzen, und Automatisierung kann SLAs auf Basis von Echtzeit-Evidenz durchsetzen. Auch das Debugging wird vereinfacht: Bei unerwartetem Verhalten kann sofort geprüft werden, ob die zugrundeliegende Projektion zum Nutzungszeitpunkt aktuell war. Das Resultat ist eine Plattform, die nicht nur transparenter, sondern auch vorhersehbarer und für alle Beteiligten sicherer ist.
04
Mehr erfahren
Wie wird das neue projection_fresh-Signal Ihre Health-Checks, Monitoring-Strategien oder selbstheilende Automatisierung auf dem Helpifyr-Stack verändern? Welche neuen Möglichkeiten ergeben sich, wenn Projektion-Aktualität als messbarer, vertraglich gesicherter Wert vorliegt? Falls Sie externe Systeme integrieren: Wie könnte diese Evidenz sicherere und autonomere Workflows ermöglichen?
Begriffe aus diesem Beitrag
- PR
- Pull Request: eine geprüfte Code-Änderung, die ins Projekt übernommen wird.
- repo
- Repository: ein Code-Projekt in der Versionsverwaltung.
Wie würde das in Ihrem Betrieb aussehen?
Ein Pilot zeigt es an einem echten Ablauf.
Mehr zu Blog und Automatisierung
Alle ansehen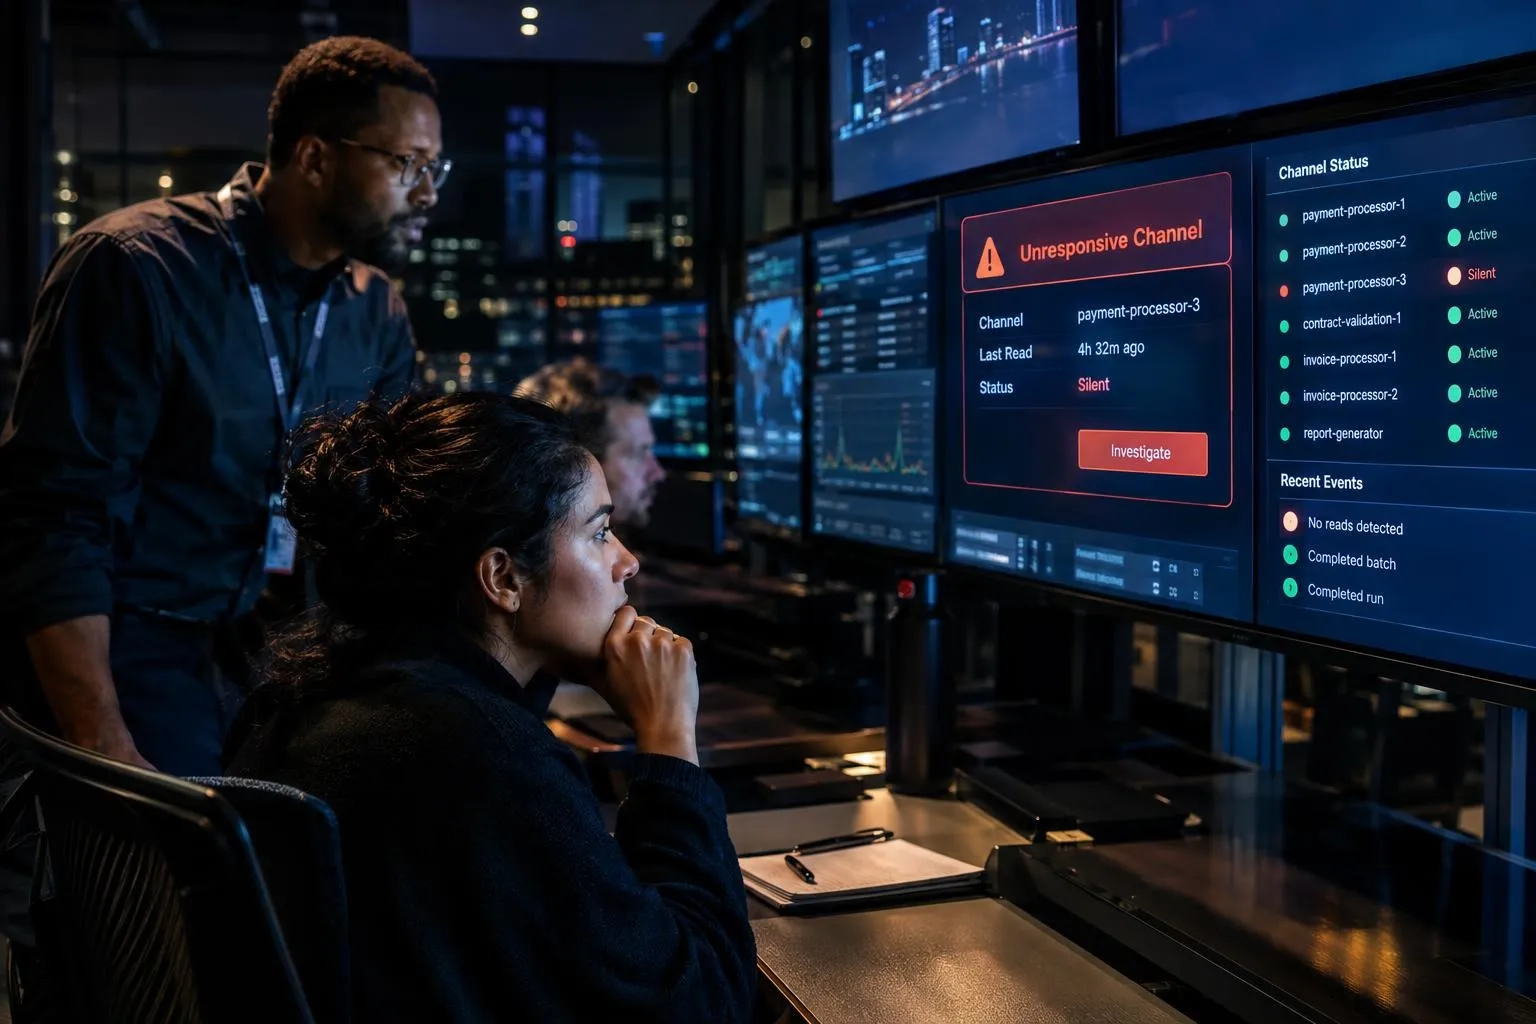 Blog und Automatisierung
3 Min.
K-Wache und Doubtfire Control: Fortschrittliche Überwachung für stille Ausfälle in Zahlungs- und Vertragsprozessen
Die heutige technische Neuerung etabliert eine zusätzliche, automatisierte Sicherheitsschicht für produktive Zahlungs- und Vertragsabwicklungslanes. Mit der Einführung des K-Wache Silent-Read-Detektors und des Doubtfire Control Timer-/Ledger-Systems erkennt und adressiert der Helpifyr/JaddaHelpifyr-Stack nun proaktiv nicht reagierende oder blockierte Lanes. Damit werden nicht nur stille Datenverluste und operative Blindspots verhindert, sondern auch neue Garantien für Betreiber und Entwickler geschaffen, die auf nachvollziehbaren, termingerechten Pipeline-Fortschritt angewiesen sind.
Lesen Blog und Automatisierung
3 Min.
Filtered Admission Surfaces: Raising the Floor for Daily Publication Security
Today, we advanced the Helpifyr / JaddaHelpifyr stack's daily publication process by enforcing filtered admission surfaces across core Boost and JHF components. This move tightens the evidence contract for what can be published each day, reducing the attack surface and eliminating accidental leakage paths by making every surface explicit, reviewable, and testable.
Lesen Blog und Automatisierung
2 Min.
Self-Healing Blog Dispatch: Eliminating Silent Failures in Automated Publishing
Today's engineering work closes a subtle but critical gap in Helpifyr's automated blog publishing. By rooting out dispatch hangs, SHA mismatches, and timeout regressions in the n8n-driven shuttle, we convert what were once silent, hard-to-debug failures into explicit, actionable outcomes. This shift ensures that the daily engineering blog, a key artifact for developer and operator alignment, is always reliably published or explicitly fails closed.
Lesen