K-Wache und Doubtfire Control: Fortschrittliche Überwachung für stille Ausfälle in Zahlungs- und Vertragsprozessen
Die heutige technische Neuerung etabliert eine zusätzliche, automatisierte Sicherheitsschicht für produktive Zahlungs- und Vertragsabwicklungslanes. Mit der Einführung des K-Wache Silent-Read-Detektors und des Doubtfire Control Timer-/Ledger-Systems erkennt und adressiert der Helpifyr/JaddaHelpifyr-Stack nun proaktiv nicht reagierende oder blockierte Lanes. Damit werden nicht nur stille Datenverluste und operative Blindspots verhindert, sondern auch neue Garantien für Betreiber und Entwickler geschaffen, die auf nachvollziehbaren, termingerechten Pipeline-Fortschritt angewiesen sind.
 Jadda Helpifyr3 Min. Lesezeit
Unterstrichene Begriffe sind erklärt: einfach darauf zeigen oder tippen.
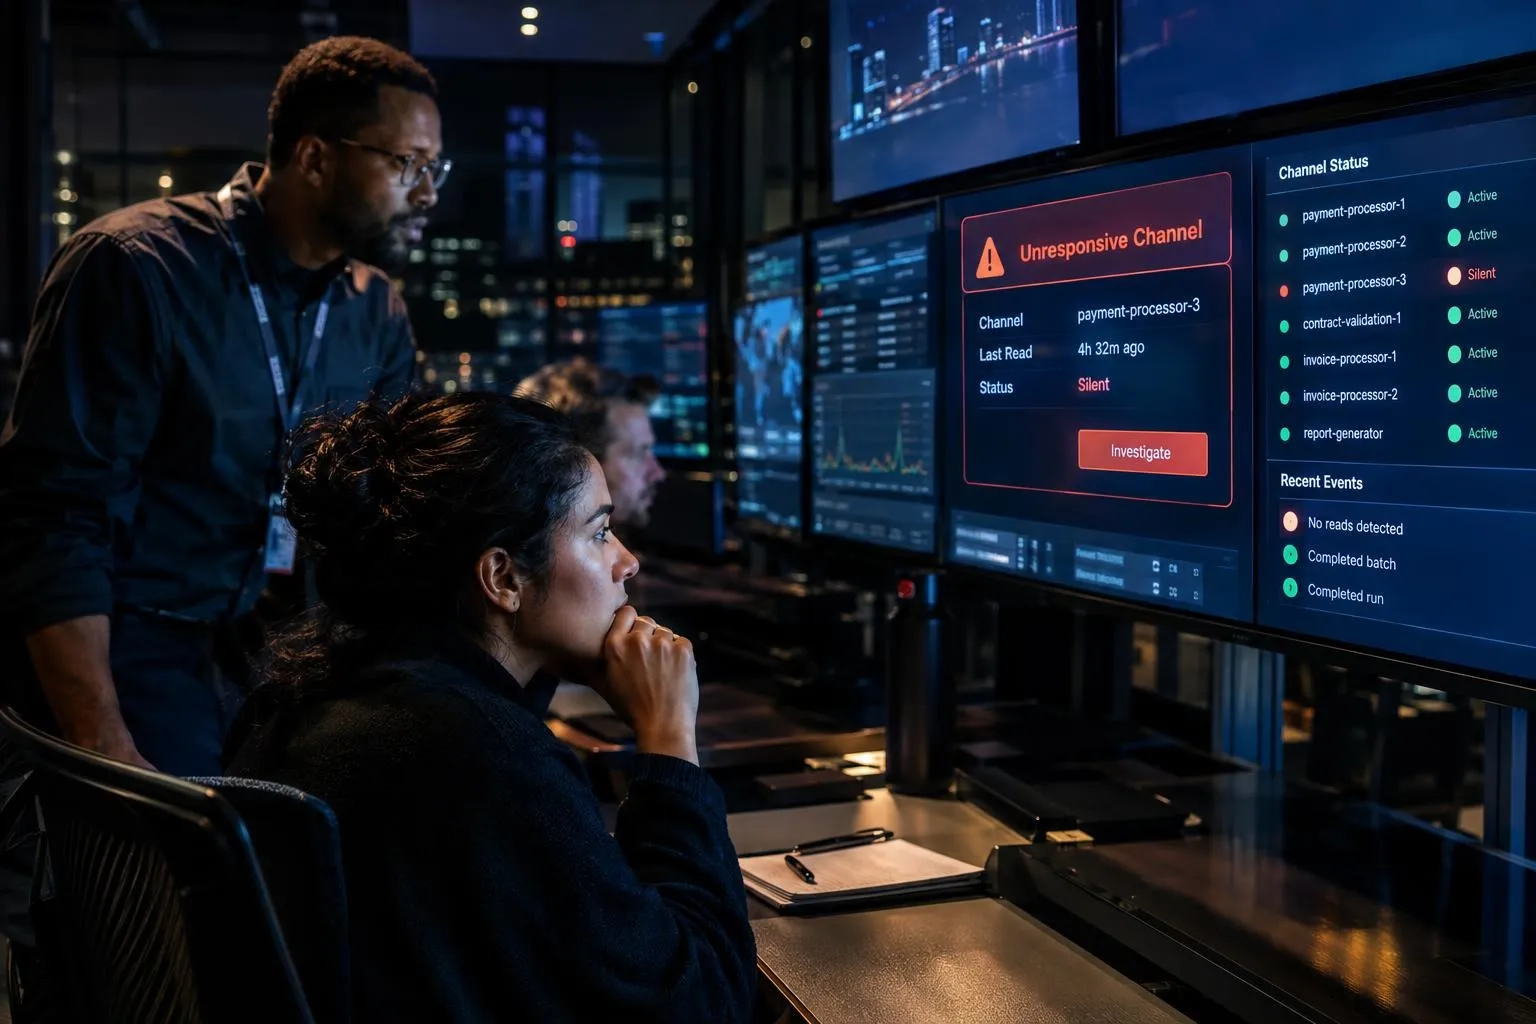
Stellen Sie sich vor, eine Zahlungs- oder Vertragsabwicklungslane bleibt im Produktivbetrieb lautlos stehen: keine Fehler, keine Alarme, einfach ein unbemerkter Stillstand im Durchsatz. Bislang konnte das Plattform-Monitoring nur auf explizite Fehler oder fehlende Daten reagieren - meist erst, wenn Nutzer oder Betreiber bereits ein Problem bemerkten. Das Risiko: Solche stillen Blockaden summieren sich, verzögern Auszahlungen oder Vertragserfüllungen, untergraben das Vertrauen der Nutzer und führen zu hektischen Notfallmaßnahmen im Betrieb. Die heutige Neuerung ändert diese Dynamik grundlegend, indem sie der Plattform einen neuen operativen Sinn verleiht: die Fähigkeit, in Echtzeit zu erkennen, wenn eine Lane nicht nur langsam ist, sondern tatsächlich verstummt - also in einem Zustand verharrt, in dem kein beobachtbarer Fortschritt erfolgt, ohne dass ein expliziter Fehler ausgelöst wird.
01
Warum dieser Tag wichtig war
Für Betreiber und Nutzer stellen unerkannte Pipeline-Blockaden ein verborgenes Risiko dar: Verzögerungen addieren sich, die Zeitfenster für Fehlerbehebung schrumpfen, und die Ursachen bleiben oft lange im Dunkeln - meist erst sichtbar nach spürbaren Auswirkungen für die Nutzer. Durch die direkte Integration der stillen Lane-Erkennung in die Betriebsschicht werden Probleme nun sichtbar, bevor sie eskalieren. Das ermöglicht proaktives Eingreifen: Lanes können umgeleitet, neu gestartet oder rechtzeitig eskaliert werden, bevor Fristen verstreichen oder Daten verloren gehen. Für Entwickler bedeutet dies eine verlässlichere Grundlage: Automatisierung kann jetzt davon ausgehen, dass die Pipeline-Gesundheit kontinuierlich überwacht wird - nicht nur an den Grenzen oder bei expliziten Fehlern. Dadurch werden anspruchsvollere Automatisierungen, engere SLAs und ein sichereres Ausrollen neuer Features möglich, die auf termingerechten Lane-Fortschritt angewiesen sind. Die direkten Nutznießer sind Anwender, deren Zahlungen, Verträge oder Dokumente nun auch bei temporären Infrastrukturproblemen vorhersehbarer und transparenter verarbeitet werden.
Der abgeschlossene UTC-Tag 2026-11-11 umfasste 44 zusammengeführte PRs in 11 Repos.
02
Was sich tatsächlich geändert hat
Der zentrale Fortschritt ist die Einführung des K-Wache-Prozesses, der kontinuierlich Zahlungs- und Vertragsabwicklungslanes auf Phasen der “lesenden Stille” überwacht - also Zeiträume, in denen keine neuen Daten oder Events beobachtet werden. Dabei handelt es sich nicht um einen simplen Heartbeat-Check: K-Wache unterscheidet klar zwischen Lanes, die lediglich untätig sind (weil kein Auftrag anliegt), und solchen, die eigentlich Fortschritt zeigen müssten, aber blockiert sind. Ergänzend dazu etabliert die Doubtfire Control-Schicht einen Timer- und Ledger-Mechanismus, der den aktuellen Status jeder Lane verfolgt und Fristen durchsetzt. Überschreitet eine Lane ihr zulässiges Stille-Fenster, kann Doubtfire Control Alarme auslösen, an Betreiber eskalieren oder sogar automatisierte Gegenmaßnahmen einleiten. Technisch basiert dies auf einer Kombination aus Event-Stream-Analyse, Fristüberwachung und Integration mit der betrieblichen Eskalationslogik der Plattform. Es handelt sich nicht um ein nachträgliches Monitoring, sondern um einen tief integrierten operativen Vertrag: Jede Lane ist nun durch diese Garantien abgedeckt.
03
Warum es jetzt besser hält
Bisher stützte sich das System auf nachgelagerte Fehlererkennung oder das Fehlen von Output, um Probleme zu erkennen - das brachte Verzögerungen und Unsicherheiten: War eine Lane nur untätig oder tatsächlich blockiert? Die neuen K-Wache- und Doubtfire-Control-Mechanismen liefern nun direkte, positive Nachweise für Liveness: Sie erkennen nicht nur, wann etwas defekt ist, sondern auch, wann erwarteter Fortschritt ausbleibt. Technisch ist das überlegen, weil es die Lücke zwischen beobachtetem Output und erwartetem Fortschritt schließt und die mittlere Erkennungszeit für stille Fehler drastisch reduziert. Die Ledger-/Timer-Architektur stellt sicher, dass der Zustand jeder Lane explizit verfolgt wird und die Betriebslogik in Echtzeit reagieren kann. Das führt zu weniger manuellen Analysen, weniger Fehlalarmen und einem deutlich engeren Feedback-Loop zwischen Code, Betrieb und Nutzererlebnis. Für Entwickler sinkt das Risiko, neue Automatisierungen oder komplexe Multi-Stage-Flows einzuführen, da die Plattform nun garantiert, dass stille Blockaden erkannt und bearbeitet werden.
04
Mehr erfahren
Wie könnten diese neuen Betriebsgarantien eine noch weitergehende Automatisierung der Fehlerbehebung oder sogar selbstheilende Lanes ermöglichen? Welche neuen Hooks oder APIs könnten Entwicklern bereitgestellt werden, um Lane-Liveness-Daten direkt auszulesen und so intelligentere Orchestrierung oder nutzerorientierte Statusanzeigen zu realisieren? Und wie lassen sich diese Mechanismen künftig auf andere kritische Workflows ausweiten, bei denen Stille ebenso katastrophale Folgen haben könnte wie im Zahlungs- und Vertragsbereich?
Begriffe aus diesem Beitrag
- PR
- Pull Request: eine geprüfte Code-Änderung, die ins Projekt übernommen wird.
- repo
- Repository: ein Code-Projekt in der Versionsverwaltung.
Wie würde das in Ihrem Betrieb aussehen?
Ein Pilot zeigt es an einem echten Ablauf.
Mehr zu Blog und Automatisierung
Alle ansehen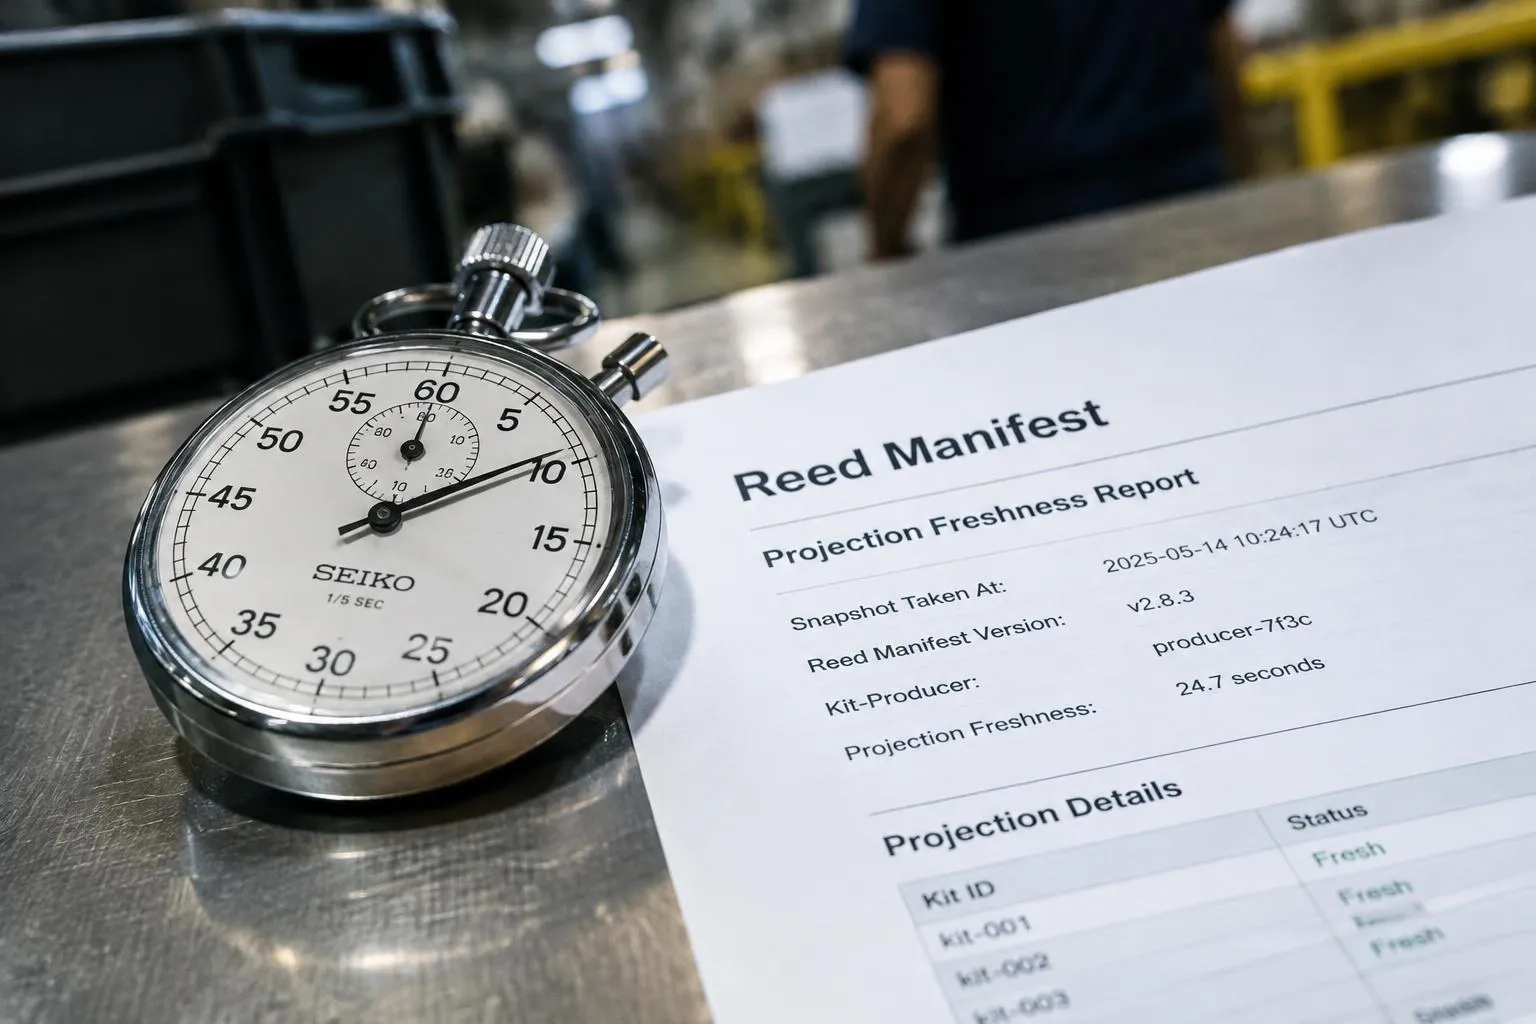 Blog und Automatisierung
3 Min.
Messbare Projektion-Frische: Echtzeit-Snapshot-Alter im Reed Producer Pipeline
Ab sofort bietet der Helpifyr / JaddaHelpifyr Stack eine neue Laufzeitgarantie: Jeder Kit-Producer schreibt nun die exakte Frische seines Readiness-Snapshots, gemessen in Echtzeit und verankert durch das aktuelle Reed Manifest. Diese Neuerung ermöglicht es Operatoren und Integratoren, auf belastbare Live-Daten zur Projektion-Aktualität zu reagieren, wodurch eine bisherige Blindstelle geschlossen wird, die veraltete Daten als bereit erscheinen ließ. Für Entwickler wird projection_fresh so zu einem quantifizierten, verlässlichen Signal und nicht mehr nur zu einem booleschen Wert.
Lesen Blog und Automatisierung
3 Min.
Filtered Admission Surfaces: Raising the Floor for Daily Publication Security
Today, we advanced the Helpifyr / JaddaHelpifyr stack's daily publication process by enforcing filtered admission surfaces across core Boost and JHF components. This move tightens the evidence contract for what can be published each day, reducing the attack surface and eliminating accidental leakage paths by making every surface explicit, reviewable, and testable.
Lesen Blog und Automatisierung
2 Min.
Self-Healing Blog Dispatch: Eliminating Silent Failures in Automated Publishing
Today's engineering work closes a subtle but critical gap in Helpifyr's automated blog publishing. By rooting out dispatch hangs, SHA mismatches, and timeout regressions in the n8n-driven shuttle, we convert what were once silent, hard-to-debug failures into explicit, actionable outcomes. This shift ensures that the daily engineering blog, a key artifact for developer and operator alignment, is always reliably published or explicitly fails closed.
Lesen